PRISMA Wizard: una revisión sistemática donde la IA ordena y argumenta, y usted decide
Hice mi revisión de literatura con una hoja de cálculo de 641 filas y juré que no volvía. Esto es lo que construí en su lugar, lo que descubrí cuando lo medí contra la herramienta de referencia del área —que gana—, los doce fallos de mi propia revisión, y cuándo lo voy a liberar.
Si usted ha hecho una revisión sistemática de literatura, sabe cómo empieza: con entusiasmo y con Excel. Se corre la búsqueda en Scopus, llegan cuatrocientos setenta y tres registros; se corre en Web of Science, llegan ciento sesenta y ocho más. Se pegan en una hoja. Se abre otra hoja para ir marcando cuáles sirven. A la tercera semana hay tres hojas que ya no cuadran entre sí, nadie recuerda por qué se excluyó la fila 212, y el diagrama —ese embudo que exige el estándar y que un jurado revisa con el dedo— se dibuja a mano, con números que hay que recontar cada vez.
Yo llegué a ese punto en agosto, con la revisión de mi tesis doctoral. Y como soy profesor de matemáticas y ciencias, y no bibliotecólogo, hice lo que hago con los problemas que se repiten: le construí una herramienta.
Se llama PRISMA Wizard. Este artículo cuenta qué es, qué hace distinto, qué descubrí cuando la puse a prueba —incluida una parte que estaba mal— y cuándo la voy a liberar para que cualquiera la use y, si quiere, la mejore.
Primero, dos palabras
Una revisión sistemática no es «leer mucho sobre un tema y resumirlo». Es un estudio en sí mismo: uno publica antes qué va a buscar y con qué reglas va a decidir, busca en varias bases de datos, lee todo lo que llegó con esas reglas en la mano, y presenta un acta donde cualquiera puede ver cuántos registros entraron, cuántos salieron en cada filtro y por qué. Lo que la separa de una revisión normal es que otra persona puede repetirla y llegar a lo mismo.
PRISMA 2020 es el formato de esa acta: una lista de veintisiete cosas que el informe final debe declarar para que la revisión sea verificable. No dice qué concluir; dice qué tiene que quedar escrito. Nació en medicina y hoy se exige igual en educación, en psicología, en ingeniería.
Y un símil que me sirvió para explicárselo a mis compañeros: una revisión sistemática es un concurso para un cargo. Se publican los requisitos antes de recibir hojas de vida, se reciben todas, se leen con los mismos requisitos, se entrevista a los que pasan, se llena la misma ficha para cada finalista y se firma un acta. PRISMA Wizard es la secretaría de ese concurso: no decide a quién contratar —eso es suyo—, pero lleva la carpeta, sella cada hoja de vida con fecha, no pierde ninguna, le pone encima las que más prometen, anota por qué cada una cumple o no cada requisito, y al final escribe el acta sola, con los números que cuadran.
La regla que ordena todo
Cuando uno dice «inteligencia artificial» y «revisión de literatura» en la misma frase, un investigador serio levanta dos objeciones. Las dos son ciertas, y conviene decirlo antes de seguir.
La primera: la IA deja estudios relevantes por fuera. Cierta para cualquier sistema que reduzca lo que la persona lee. Un clasificador que acierta el noventa y cinco por ciento de las veces pierde uno de cada veinte estudios relevantes, y nadie sabe cuál.
La segunda: desplaza el juicio del investigador. También cierta, y no hace falta un algoritmo sofisticado: basta con que la pantalla muestre la palabra «excluir» y un botón de confirmar. El clic es humano; el razonamiento ya se fue a otra parte.
Por eso PRISMA Wizard tiene una sola regla, y todo lo demás se deriva de ella:
La IA ordena y argumenta. La persona lee y decide. Ninguna referencia sale de la revisión sin que un ser humano lo decida.
En la práctica eso significa cuatro cosas que se pueden verificar en el código:
- Cuando la IA evalúa un registro, su valoración se guarda como sugerencia, no como decisión. Mientras nadie la confirme, ese registro queda retenido: no avanza a la siguiente fase, pero tampoco se borra, y aparece contado en pantalla y en el diagrama.
- La IA no decide contra una lista genérica: lee cada resumen contra los criterios que usted escribió y devuelve qué criterios cumple, cuáles viola y por qué. Lo que usted recibe no es un veredicto; es un argumento que puede refutar.
- Si usted contradice a la IA, queda escrito: la sugerencia original se conserva y el informe imprime cuántas veces el revisor se apartó de ella. Es la evidencia más honesta de que el juicio siguió siendo suyo.
- Hay una segunda opinión a ciegas: como casi nadie tiene dos revisores, la IA puede hacer ese papel, pero con las reglas de un segundo revisor de verdad —no ve lo que usted decidió, revisa una muestra y no todo, y no cambia nada—. Devuelve los desacuerdos y una medida de acuerdo. Lo que usted haga con cada desacuerdo es suyo.
Lo que hace, en cinco pantallas
Una revisión PRISMA tiene doce pasos. La herramienta los agrupa en cinco pantallas, para que el método no se vuelva un laberinto:
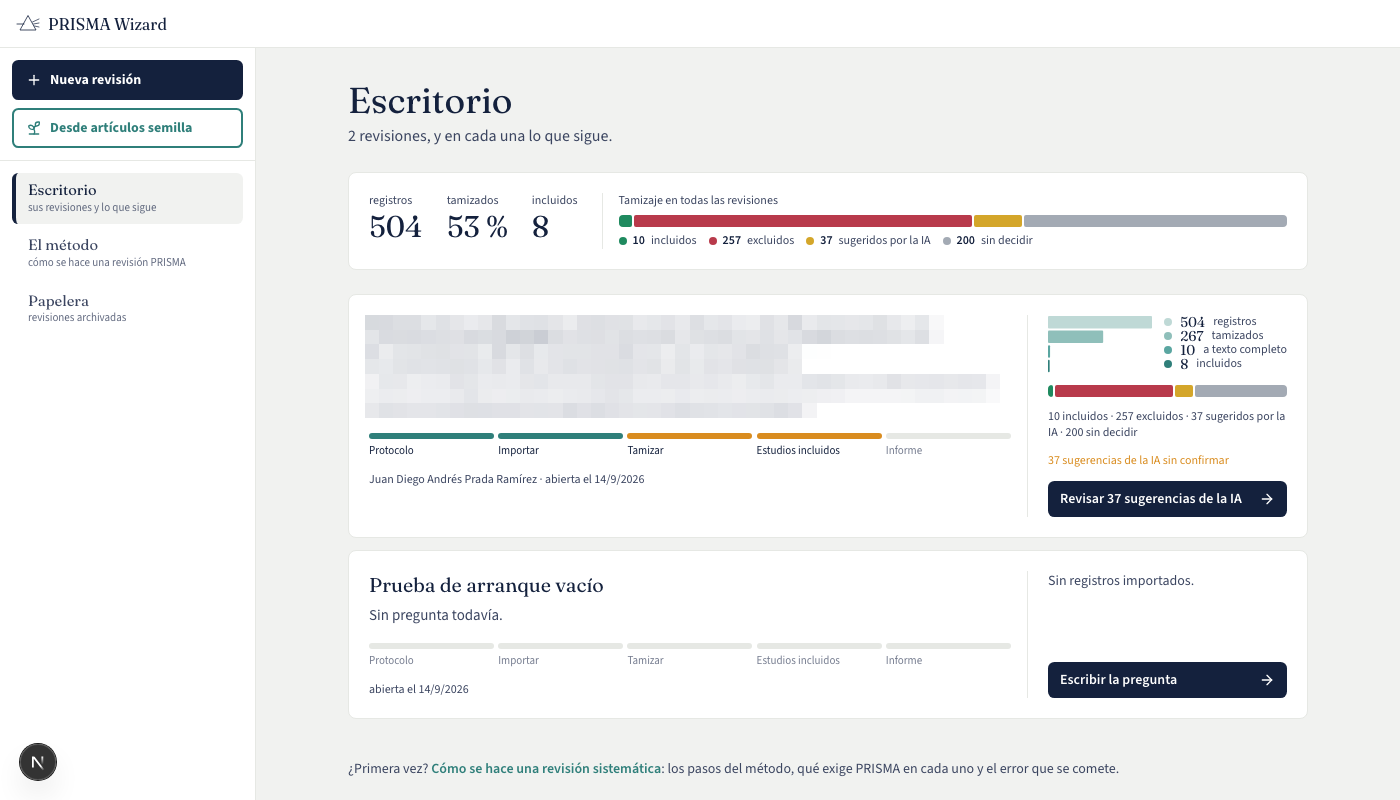
Protocolo. La pregunta, escrita con una plantilla que la hace buscable (PICO si compara intervenciones; SPIDER si estudia personas y significados; PCC si quiere un mapa). Los criterios de inclusión y exclusión, numerados. La ecuación de búsqueda, traducida a la sintaxis de cada base y con descriptores de tesauro. Si después cambia algo, queda como enmienda con fecha.
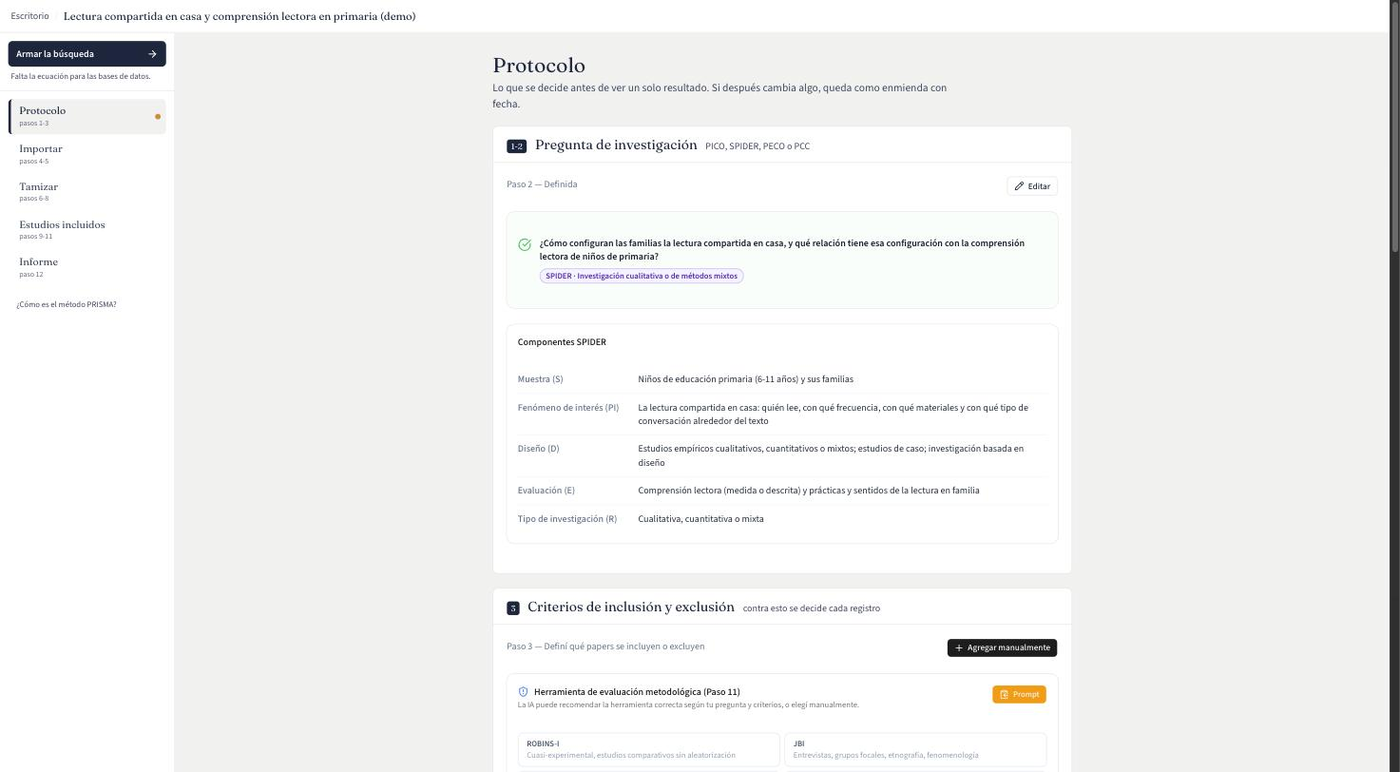
Importar. Los archivos que devuelven Scopus, Web of Science, IEEE o la base que use. Cada archivo se guarda con su huella —si alguien le cambia una coma, la huella cambia—. Los duplicados se detectan solos: los exactos por DOI, y los parecidos por título, que son los que Excel no ve.
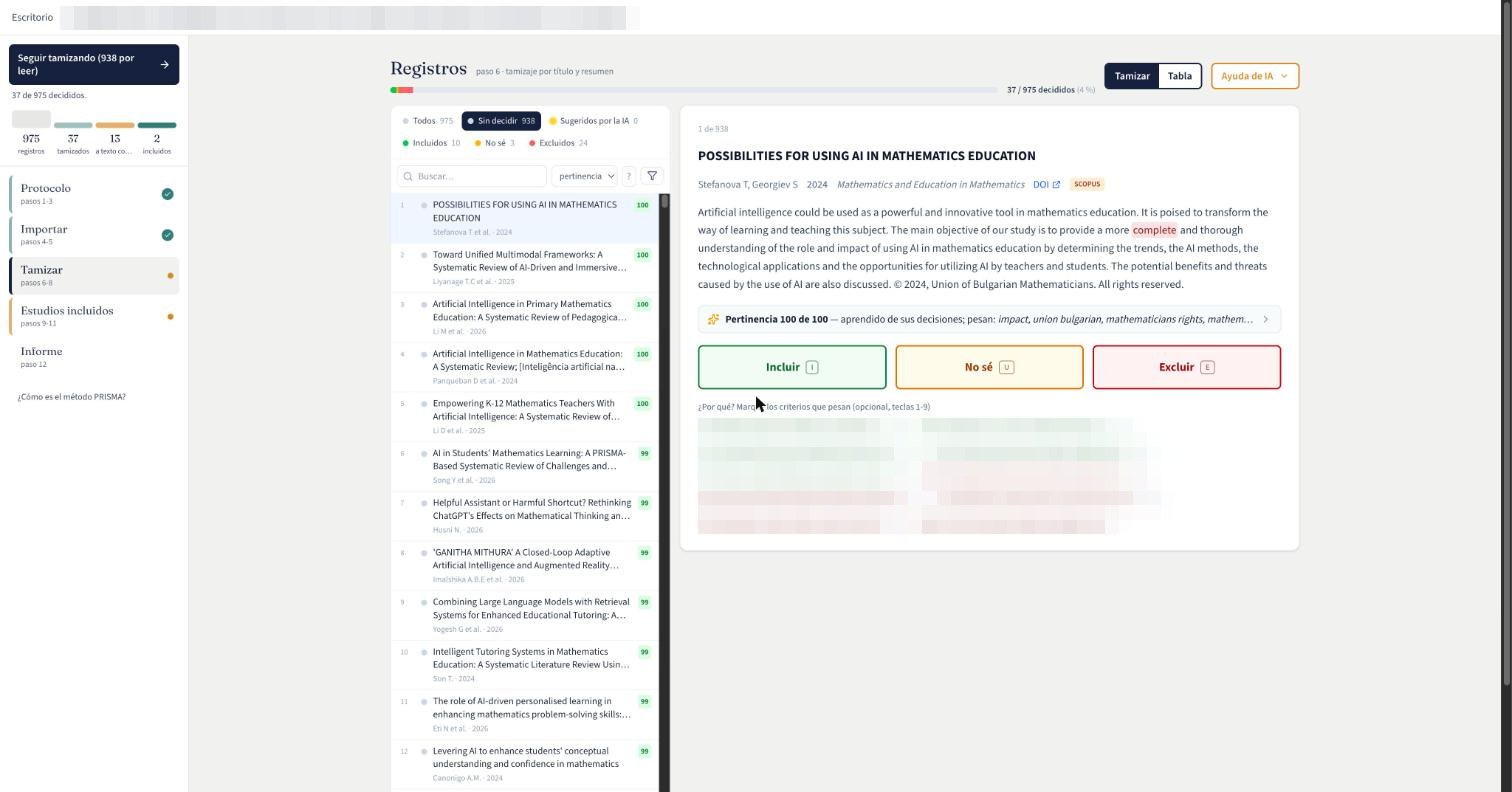
Tamizar. Un registro por pantalla, el resumen con sus términos resaltados, tres botones —incluir, no sé, excluir— y sus propios criterios como chips: un clic y la decisión lleva su razón. La IA puede ordenar lo que falta (aprende de lo que usted ya decidió) y puede sugerir; usted decide.
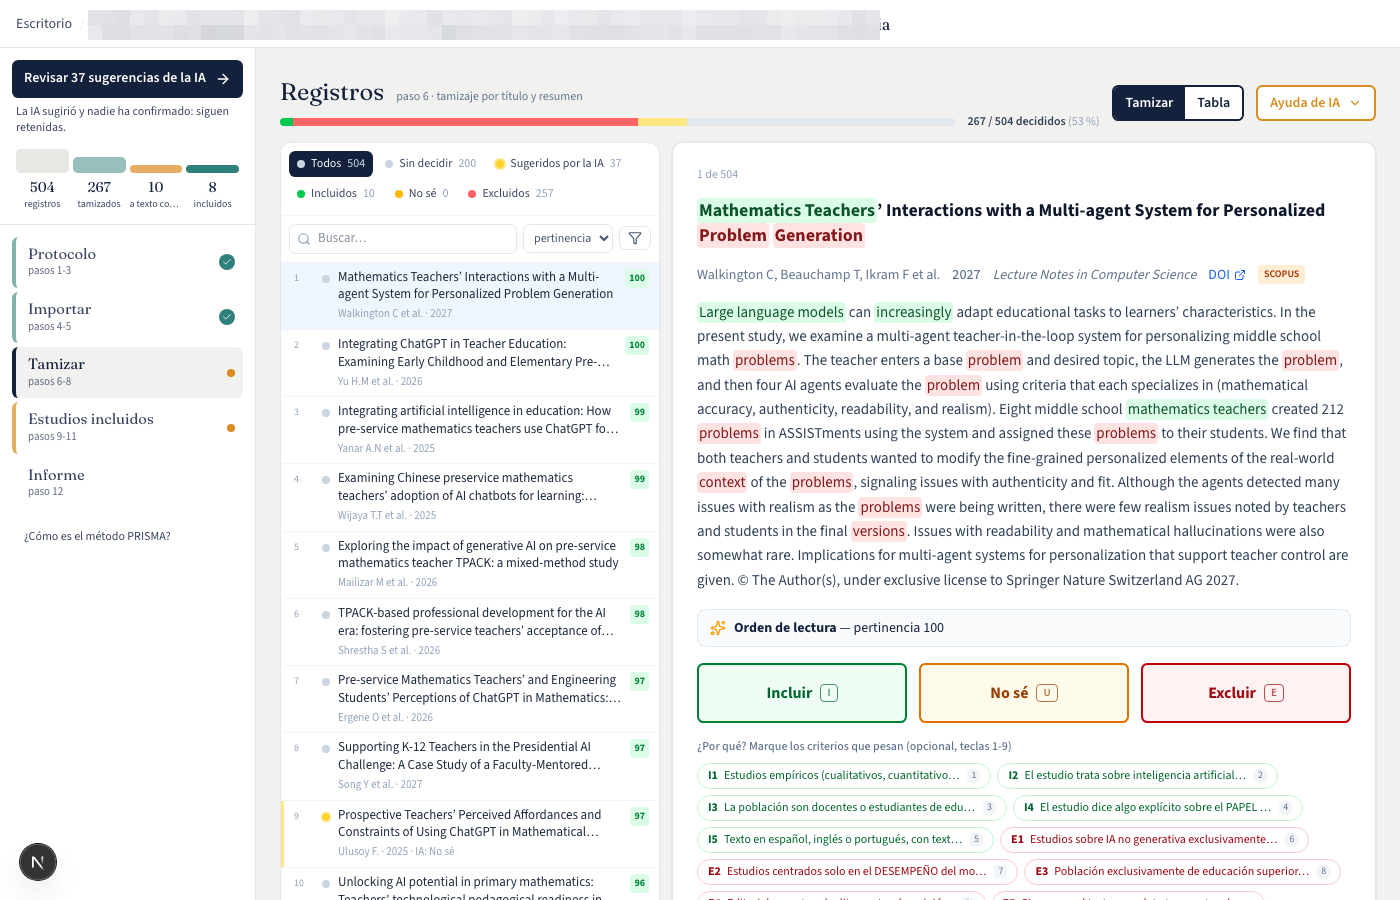
Estudios incluidos. Los que pasaron: se leen enteros con un asistente de lectura —del que hablo abajo—, se les llena la misma ficha y se verifica su calidad con la herramienta que corresponda al diseño del estudio.
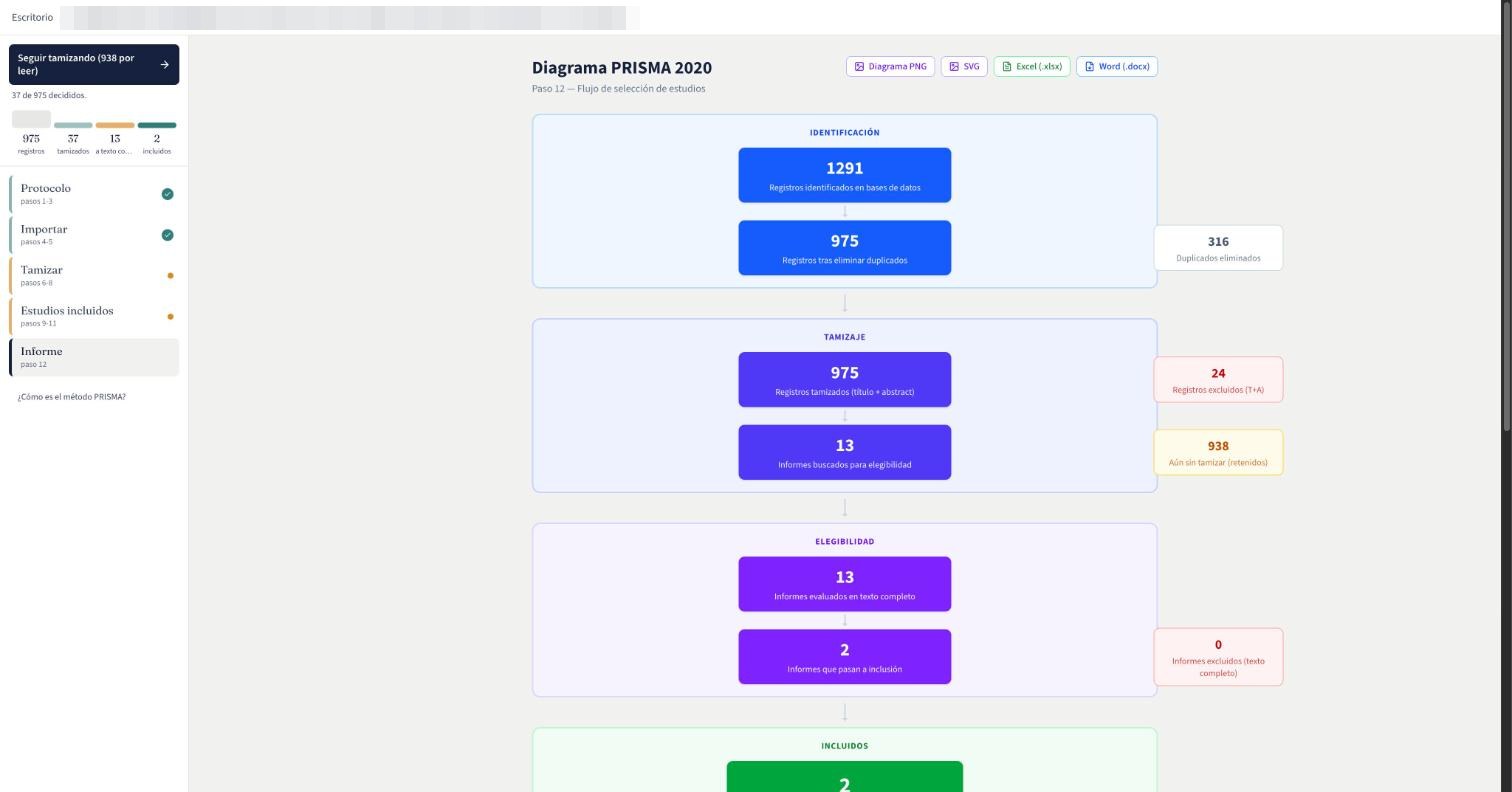
Informe. El diagrama PRISMA con los números que cuadran (cuatro igualdades que tienen pruebas automáticas: nunca va a salir un número que no sume), el informe en Word y el tablero en Excel. Y la tabla completa, que es lo que un director de tesis pide ver:
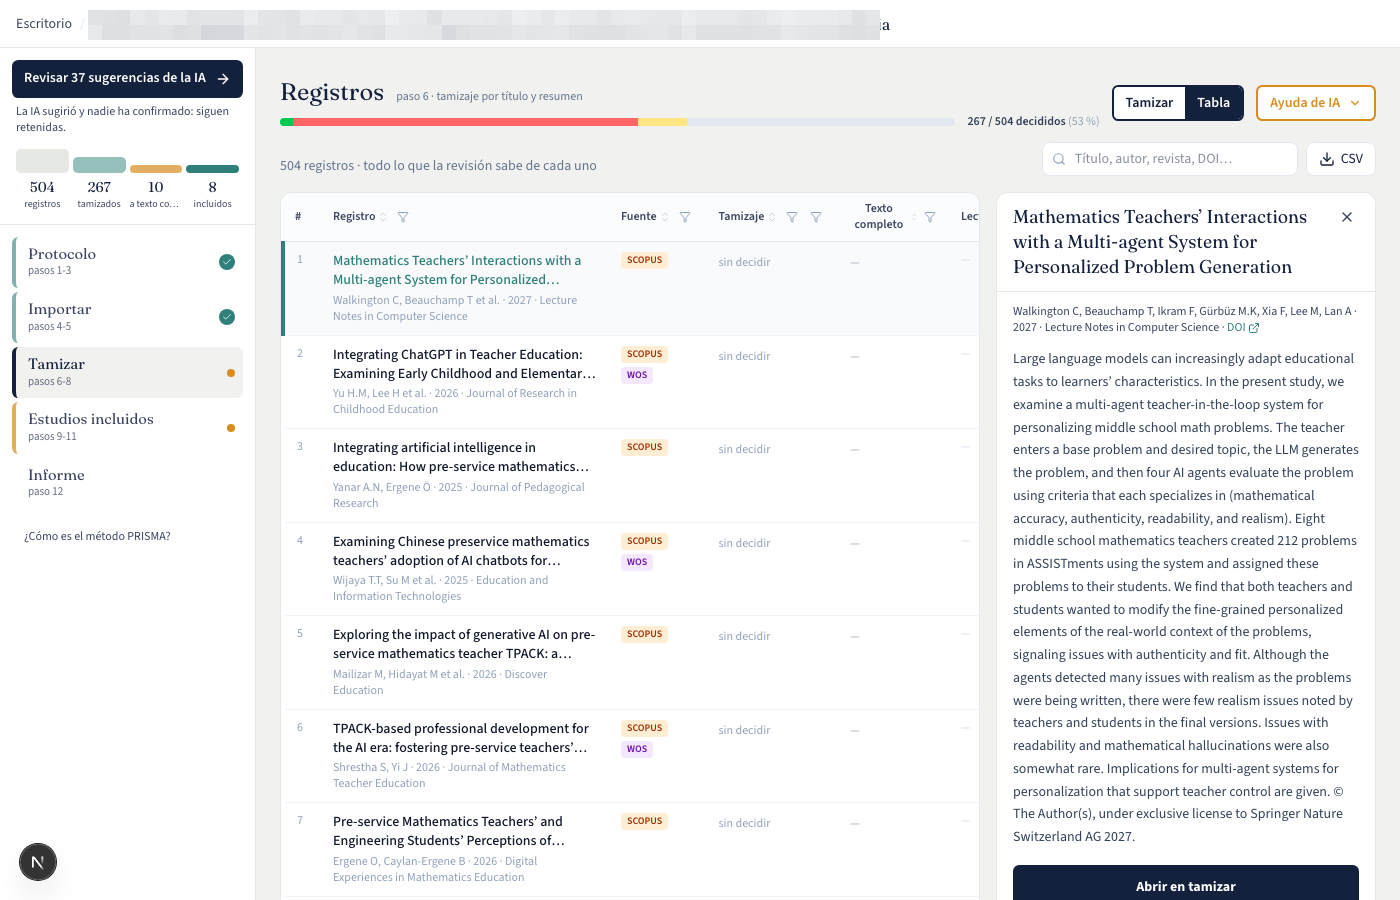
Todo en español, en la web, gratis. Y sin obligar a pagar una API de inteligencia artificial: en modo manual, la aplicación arma el texto para que usted lo pegue en ChatGPT o Claude y traiga la respuesta.
El asistente de lectura
Es la parte que más me gusta, y la que más me costó encontrar en mi propia aplicación cuando la reorganicé (lección aprendida).
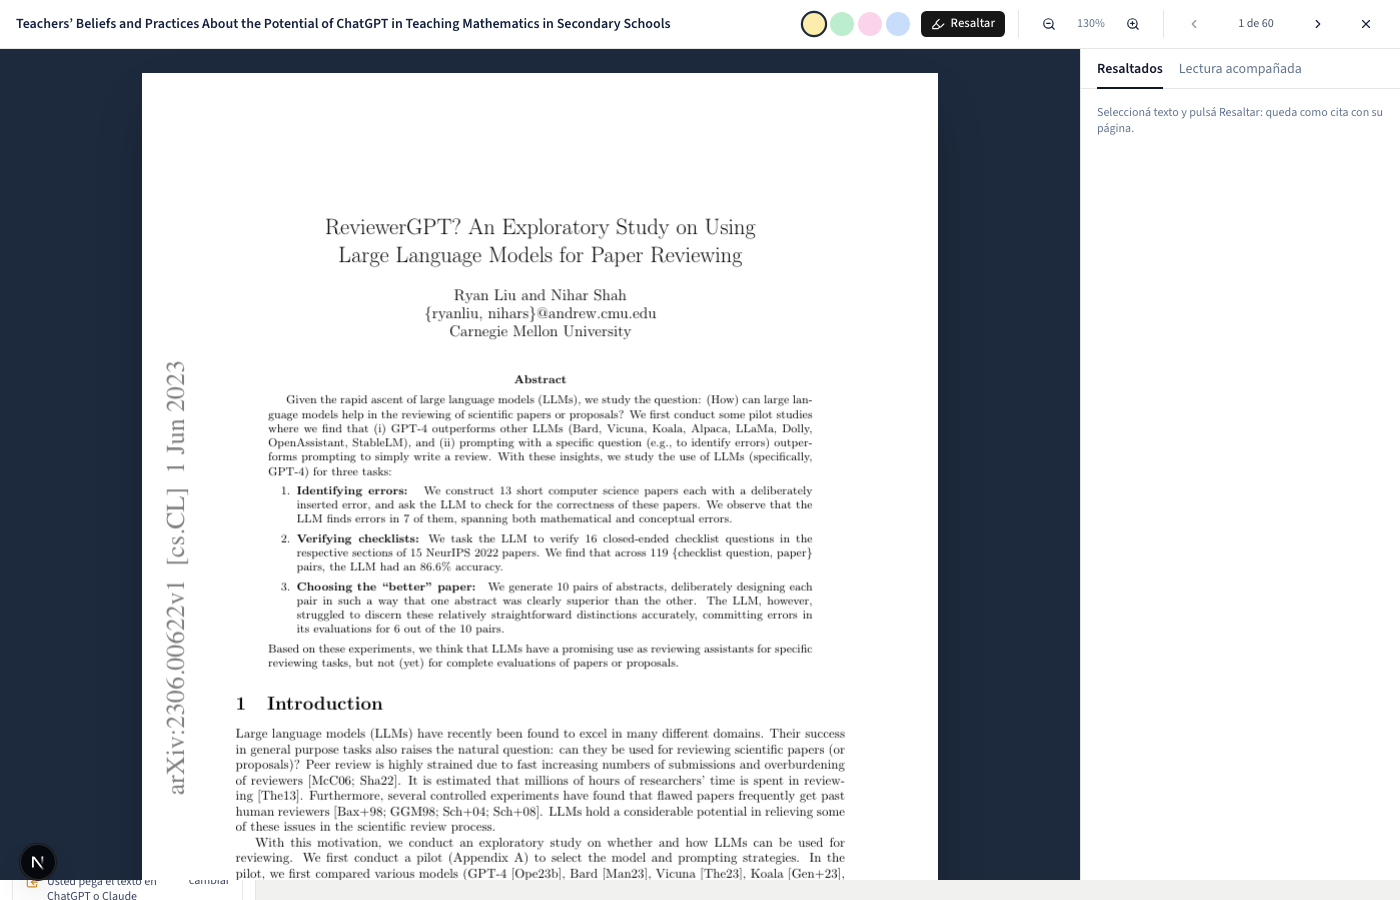
Cuando un estudio pasa a texto completo, usted pega el enlace del PDF —el del botón «Download PDF» de la editorial, o el de compartir de Google Drive— y se abre un lector con dos cosas: resaltar un párrafo lo convierte en cita con su número de página, y la pestaña Lectura acompañada hace lo que haría un buen tutor: le pide su veredicto propio primero, le pregunta qué entendió de cada tramo y lo corrige en escalera —una pregunta, una pista, el párrafo exacto, una analogía—, y al final arma la ficha con lo que usted dijo, no con lo que la máquina resumió.
Lo que descubrí cuando la medí
Aquí está la parte que un artículo promocional no contaría.
La herramienta de referencia en este campo se llama ASReview, la hizo la Universidad de Utrecht y tiene un método muy sano para evaluar si un orden de lectura sirve: se toma una revisión ya terminada, se esconden las decisiones, y se mide en qué posición del orden calculado aparece cada estudio relevante. Cuanto más arriba, mejor ordena la herramienta.
Lo apliqué primero a una revisión de prueba que había hecho con la propia herramienta —quinientos cuatro registros, ocho incluidos— y el resultado fue humillante: mi orden no era mejor que el azar. La causa estaba clara: los criterios estaban escritos en español y el corpus en inglés; los cinco registros que subían al tope eran los que traían palabras clave bilingües —«inteligencia artificial», «matemáticas»—, y eran de primaria o de universidad. El algoritmo premiaba lo raro, y lo raro era el español.
Lo reemplacé por la receta de ASReview, que es de código abierto: un clasificador que aprende de las decisiones del propio revisor y reordena lo que falta, y que desde entonces se recalcula solo cada diez decisiones.
Pero una revisión de prueba, tamizada por uno mismo, no es una vara de medir seria. Así que repetí la comparación donde la comunidad de ASReview mide sus propios modelos: la colección pública SYNERGY, revisiones ajenas y terminadas, con las decisiones de sus revisores como patrón oro. Elegí tres de educación, del tamaño de mi revisión doctoral: una sobre diseño multimedia para el aprendizaje (1.077 registros, 29 relevantes), una sobre tratamientos de la dislexia (725, 37) y una sobre estrategias de estudio (1.299, 122). Cuatro órdenes, mismo arranque —un «sí» y un «no» al azar, tres veces— y una sola pregunta: ¿cuántos registros hay que leer para encontrar el 95 % de los relevantes?
| Hoja de cálculo | Wizard v1 (palabras) | Wizard hoy | ASReview | |
|---|---|---|---|---|
| Multimedia y aprendizaje (1.077) | 1.015 | 1.004 | 214 | 198 |
| Tratamientos de dislexia (725) | 705 | 714 | 464 | 323 |
| Estrategias de estudio (1.299) | 1.270 | 939 | 535 | 491 |
Tres cosas se leen ahí. La primera confirma el fracaso: ordenar por palabras no sirve en ningún corpus, se lee casi todo. La segunda es la que hay que decir de frente: ASReview gana, no empata. Al 25 % del corpus los dos encuentran lo mismo, pero para llegar al 95 % ASReview necesita menos lecturas en los tres, y encuentra el último relevante antes en dos de tres. Verifiqué que la diferencia no venía de nada que yo hubiera añadido —la mezcla con la ecuación de búsqueda da los mismos números que sin ella—; está en cómo ASReview balancea la muestra con la que entrena, y es lo siguiente que voy a tomar de su receta. Prefiero publicar la tabla con la herramienta perdiendo que una comparación que nadie pueda repetir: el script y los tres corpus están en el repositorio.
La tercera es la que más importa, y aplica a ASReview tanto como al Wizard: ningún orden autoriza a parar. Quien deje de leer al 20 % del corpus —que es lo que algunas herramientas sugieren— pierde, incluso con ASReview, 1 o 2 relevantes de 29, entre 9 y 12 de 37, y entre 26 y 28 de 122. Por eso PRISMA Wizard adopta el orden de ASReview pero no su regla de parada: ordena para leer mejor, no para leer menos. Y si alguien decide parar, la caja «aún sin tamizar» del diagrama lo declara.
Y entonces, ¿para qué la IA, si ASReview ordena mejor sin ella? Lo medí también, en el corpus donde la brecha era mayor. ASReview arranca a ciegas: un «sí» y un «no» al azar, y aprende de ahí. PRISMA Wizard tiene algo que ASReview no puede tener: un modelo de lenguaje que lee los criterios y puntúa cada registro antes de la primera decisión. Solo con ese orden, sin aprender nada todavía, al leer el 25 % del corpus ya había aparecido el 92 % de los relevantes (ASReview: 78–84 %); y combinando la IA (70 %) con el aprendizaje (30 %), el Wizard iguala a ASReview en el 95 % y pierde menos si alguien para. El valor de la IA está al principio, que es justo donde el revisor calibra sus criterios. Lo declaro como piloto: un corpus, solo títulos, y el puntuador fue el asistente en modo copiar y pegar, no un modelo por API; se repite en los otros dos corpus antes del encuentro.
Una limitación que también va escrita: los registros públicos de SYNERGY vienen de OpenAlex, que solo trae el resumen de un tercio de ellos, así que las dos herramientas ordenaron casi solo con títulos, en igualdad de condiciones.
Lo cuento porque es exactamente lo que le pedimos a la máquina: someterse a auditoría y corregirse con datos.
El flujo, paso a paso, con mi propia revisión
Para que este artículo no hablara de una demo, corrí en la herramienta la revisión de mi tesis doctoral de principio a fin, el 14 y 15 de septiembre. El protocolo —la pregunta, los criterios, la ecuación— no lo publico todavía: es una investigación en curso. Lo que sí cuento es lo que pasó en cada pantalla, con los números reales y con lo que cada paso destapó. Porque destapó bastante.
1. Protocolo: la pregunta, los criterios y la búsqueda, antes de mirar nada
La pregunta se escribe con la plantilla SPIDER (muestra, fenómeno, diseño, evaluación, tipo de investigación), porque estudia personas y significados, no compara dos tratamientos. Los diez criterios quedan numerados —I1 a I5, E1 a E5— y esos códigos son los chips que después llevan la razón de cada decisión.
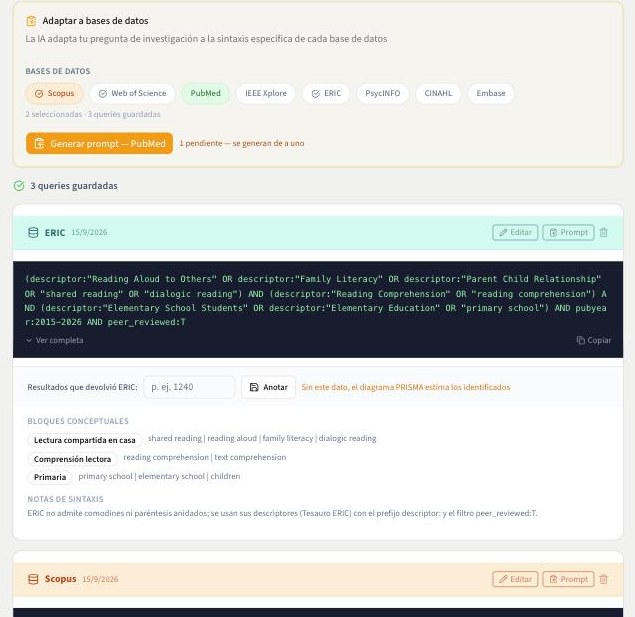
La ecuación se arma una sola vez, en bloques unidos con AND —uno por
componente de la pregunta, con los sinónimos de cada bloque unidos con OR—,
y la herramienta genera la versión para cada base, porque cada una habla
su dialecto: Scopus quiere TITLE-ABS-KEY(...) y PUBYEAR > 2021; Web of
Science, TS=(...) con sus propios operadores de proximidad; ERIC no acepta
comodines ni paréntesis anidados y prefiere sus descriptores. Escribir las
tres a mano es la fuente clásica de «en una base busqué una cosa y en otra,
otra». Usé las tres: Scopus y Web of Science, las de siempre, y ERIC —la
base de educación del Departamento de Educación de Estados Unidos, gratuita y
con tesauro propio— porque buena parte de la investigación educativa
estadounidense no está en las otras dos. Los descriptores de tesauro —UNESCO
y ERIC— quedan con su URI, para que cualquiera los verifique.
Primer tropiezo: los descriptores no se registraban. El buscador del tesauro añadía un asterisco y la API de la UNESCO devuelve cero resultados cuando la consulta tiene dos palabras y comodín («inteligencia artificial*» → nada; «inteligencia artificial» → cinco). Cualquier descriptor de dos palabras fallaba en silencio. Arreglado esa noche.
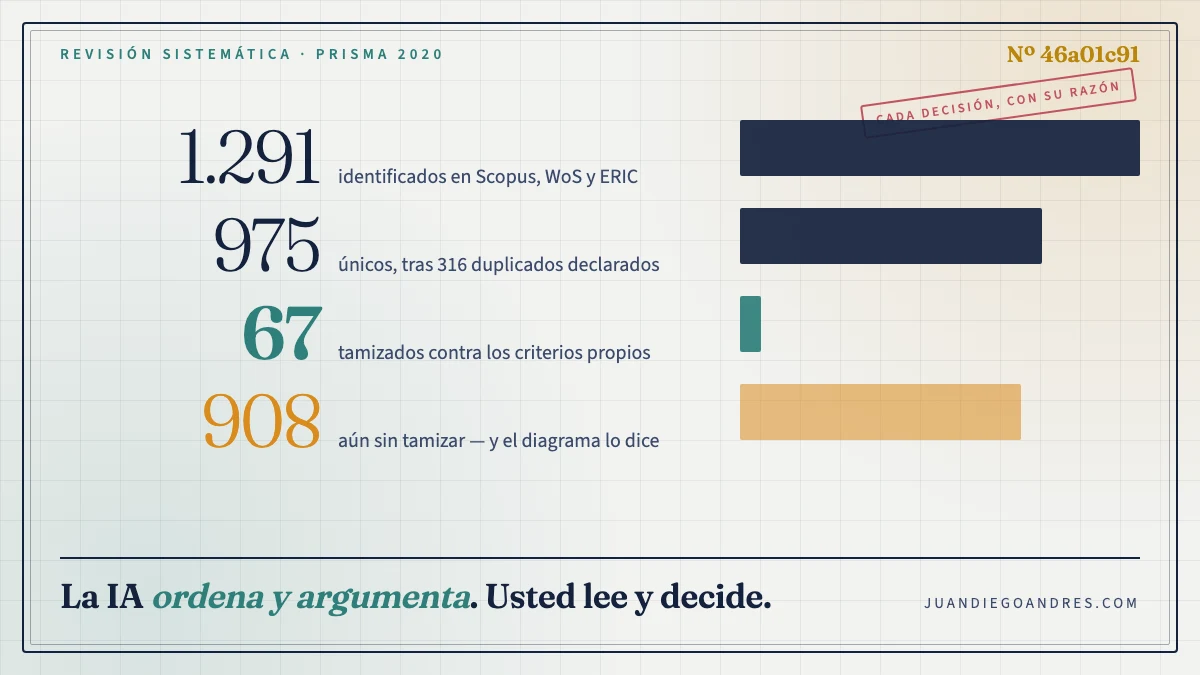
2. Importar: 1.291 registros, 316 duplicados, 975 para tamizar
ERIC devolvió 93, Scopus 836, Web of Science 362. La importación fusiona sola los que traen el mismo DOI (265) y guarda cada archivo con su huella SHA-256. Los «parecidos» por título —51, el mismo artículo con mayúsculas de ERIC y minúsculas de Scopus— se confirman uno a uno. Quedaron 975.
Y ahí salió el primer error serio. Al confirmar los 51 conservé siempre el registro «A», que era el de ERIC —la base que no exporta DOI—, y la fusión borraba el de Scopus con el DOI. Cincuenta y tres artículos se quedaron sin enlace a su texto completo, y nadie lo habría notado hasta la fase de lectura. Dos arreglos: fusionar ya rescata del descartado lo que le falte al conservado, e importar reconoce por título un registro que ya estaba sin DOI y lo completa en vez de duplicarlo. Reimporté Scopus y WoS y los 53 recuperaron su DOI sin que el conteo se moviera. De paso: el botón de «conservar» se movía al hacer clic porque la tarjeta cambiaba de ancho; evaluar 51 pares así no es un clic por par, es perseguir el botón. Ahora los botones están fijos, la app recomienda cuál conservar y se puede aceptar la recomendación para todos. Y el Excel tiene una hoja «Duplicados» con cada colapso: fecha, cómo se reconoció, de qué base venía, cuál se conservó.
3. Tamizar: el orden es un cálculo, no un juicio, y se explica
Aquí me equivoqué yo, no la app. El primer lote de veinte lo tomé en orden de importación —ERIC primero— y salió pura periferia: sistemas tutoriales clásicos, docentes en formación, comentarios sin datos. Deshice el lote (queda en la bitácora, con la razón) y cambié la app para que el orden por pertinencia llegue solo al importar y, sobre todo, para que diga por qué: cada registro muestra «Pertinencia 84 de 100 — por las palabras de la ecuación y los criterios; pesan: scaffolding, secondary, ChatGPT», y un botón «?» explica el método vigente.
La transparencia pagó de inmediato, tres veces:
- El primer registro del orden léxico estaba arriba porque traía el título en español y coincidía con dos palabras de mis criterios, que están en español. El sesgo bilingüe que ya había medido, ahora a la vista.
- Con 37 decisiones el orden pasó a aprendido (TF-IDF + SVM, la receta de ASReview) y puso arriba… revisiones sistemáticas. Porque entre mis diez incluidos había dos revisiones y el clasificador aprendió «review, systematic» como señal. Con pocos positivos aprende el patrón más fácil, y el patrón más fácil no siempre es el tema.
- Y el porqué de otro registro decía union bulgarian, mathematicians rights: el clasificador había aprendido la línea de copyright que Scopus pega al final del resumen («© 2024, Union of Bulgarian Mathematicians. All rights reserved») porque yo había incluido un artículo de esa revista. Sin el porqué en pantalla, ese ruido habría ordenado mi lectura durante semanas. Ahora el resumen se limpia antes de aprender.
El tamizaje mismo funciona así: un registro por pantalla, tres botones, los criterios como chips. La IA, en modo «copiar y pegar» (la app arma el prompt con la pregunta y los diez criterios, uno pega la respuesta), devolvió su lectura de 30 registros y la app la guardó como lo que es: 30 sugerencias retenidas, 0 tamizadas. Tres «incluir», tres «no sé», veinticuatro «excluir» con su criterio. La pantalla exige decidir los «no sé» a mano antes de confirmar nada en bloque. Al cierre de este artículo: 67 decididos, 10 incluidos, 4 inciertos, 53 excluidos, 908 por leer — y el diagrama lo declara.
4. La segunda opinión a ciegas
Con 37 decisiones, pedí la auditoría: la app toma una muestra reproducible (12 registros, el 32 %), arma un prompt que no incluye mis decisiones, y compara. Resultado: kappa = 0,53, tres desacuerdos. Los tres eran mis inclusiones de la muestra: dos revisiones sistemáticas y un trabajo en curso sin datos. La segunda opinión no dijo «excluir»; dijo «no sé: ¿las revisiones entran como estudios o como fuentes para la búsqueda en cadena?». Es una pregunta al protocolo, no al artículo, y es exactamente lo que un segundo revisor humano habría preguntado. Declaro también la limitación: el mismo modelo hizo las sugerencias del lote y la segunda opinión; nueve de los doce acuerdos son consigo mismo.
5. Leer: el PDF detrás del visor, la página que recuerda, la ficha al lado
Los estudios incluidos pasan a texto completo. Para conseguir el PDF hay
ahora dos botones: «Buscar el PDF abierto» consulta Unpaywall y la
etiqueta citation_pdf_url de la página del artículo, y solo registra el
enlace si lo que devuelve empieza por %PDF; si no hay versión abierta,
«Abrir en la editorial» arma el enlace directo al archivo (Springer,
Elsevier, Wiley, Taylor & Francis, SAGE, MDPI, ACM…) para bajarlo con el
proxy de la universidad y subirlo. De mis diez incluidos, tres salieron
abiertos; Springer bloquea al servidor pero no al navegador.
Otro error, contado: el buscador registró para un artículo un PDF del Banco Mundial. La regla más floja —«cualquier enlace .pdf de la página»— había tomado una referencia de la bibliografía. Ahora un enlace suelto solo vale si es del mismo sitio de la revista, y el porqué de cada hallazgo se ve.
El lector abre en la página en la que uno se quedó, marca el estudio como «leyendo» sin pedirlo, y tiene tres pestañas: Resaltados (cada resaltado es una cita con página), Lectura acompañada (el tutor que pregunta antes de resumir) y Ficha: las columnas de la matriz de ese estudio, para llenarlas leyendo; «↓ resaltado» pega el resaltado seleccionado con su página.
[Captura del lector con la ficha omitida por la misma razón; la del lector sin ficha va más arriba.]
Como ejemplo llené la ficha de uno de los incluidos: la versión exacta del modelo que usaron, las instrucciones que le dieron, las reglas de uso en el aula y el hallazgo principal quedaron en nueve columnas, cada dato con la página de donde salió. Es el tipo de estudio que la pregunta busca —la configuración está escrita y el efecto está medido—, y por eso mismo no digo cuál: forma parte de una revisión que aún no está publicada.
6. La matriz y las fichas bibliográficas
La matriz —una fila por estudio incluido, una columna por lo que se compara— aparece desde el primer «incluir», con la fila marcada «texto completo pendiente», y se llena en la pantalla o en el lector. Las columnas son del investigador: una plantilla para empezar (la de mi protocolo tiene nueve: modelo y versión, configuración reportada, diseño de mediación, marco teórico, unidad de análisis, tipo de evidencia, conducta de verificación, nivel/país/diseño, hallazgo) o las suyas desde cero, y se cambian sin perder lo escrito. Bajo cada estudio va su referencia en APA 7 con botón de copiar, y hay un RIS para Zotero.
[Captura de la matriz omitida: sus columnas y sus filas son el protocolo de una revisión en curso.]
7. El informe: los números que cuadran y lo que falta declarado
El diagrama PRISMA sale solo: 1.291 identificados, 316 duplicados, 975 tamizados, 53 excluidos, 14 buscados para elegibilidad, 2 incluidos hasta hoy — y dos cajas ámbar que ninguna herramienta pone sola: 908 aún sin tamizar y 12 aún sin leer. Cuatro igualdades tienen pruebas automáticas; nunca va a salir un número que no sume. El Excel trae la matriz, todos los artículos con su decisión en cada fase, los duplicados, la auditoría y las referencias; el Word, el informe con los 27 ítems.
8. La mañana siguiente: el orden aprendió lo que no era
Con 39 decisiones —diez «sí», dos de ellos sobre realidad virtual y agentes— volví a pedir el orden y los treinta de arriba eran restauración de murales, ecografías de gliomas, optimización de matrices para LLM y redes 6G. El modelo había aprendido «multimodal», «immersive», «conversational»; no las palabras de mi pregunta. El registro lo delató en una línea: cada fila decía por qué estaba arriba, y el porqué no tenía nada que ver con el tema.
Es el fallo más importante de la revisión, porque es el que la receta de ASReview no advierte: presupone un corpus ya acotado por la ecuación. Con una ecuación amplia (la de Scopus arrastra mucho ruido de LLM multimodal), el aprendizaje con pocas decisiones se agarra de las palabras de superficie. El arreglo no fue cambiar de modelo sino no soltar la ecuación: el orden aprendido pesa en proporción a cuántas decisiones tiene (con 67, el 67 %) y la ecuación con los criterios sostiene el resto hasta que haya unas cien. Con las mismas 67 decisiones, los treinta de arriba pasaron de veinte ajenos a treinta pertinentes, un tercio de ellos exactamente de la población que busco.
Esa misma mañana el protocolo cambió una vez (versión 2 de I1, criterio E6 nuevo): las revisiones sistemáticas dejan de contar como estudios y se guardan como fuente para la búsqueda en cadena. Queda en el registro con fecha, y las dos que ya estaban incluidas cambiaron de columna con su razón escrita.
9. El mapa: cuándo, dónde y qué citan en común
La última pieza la pidió el revisor, no el programador: con diez estudios incluidos ya se puede preguntar de qué época es la pregunta, en qué revistas vive y si esos diez leen lo mismo. La pestaña Mapa responde las tres con datos abiertos por DOI (OpenAlex, con Crossref de respaldo): una línea de tiempo, una tabla de revistas —si está en DOAJ, cuántas citas recibe por artículo, el cuartil de SCImago cuando hay tabla; un descriptor, nunca un criterio— y un grafo donde dos estudios se unen si comparten referencias.
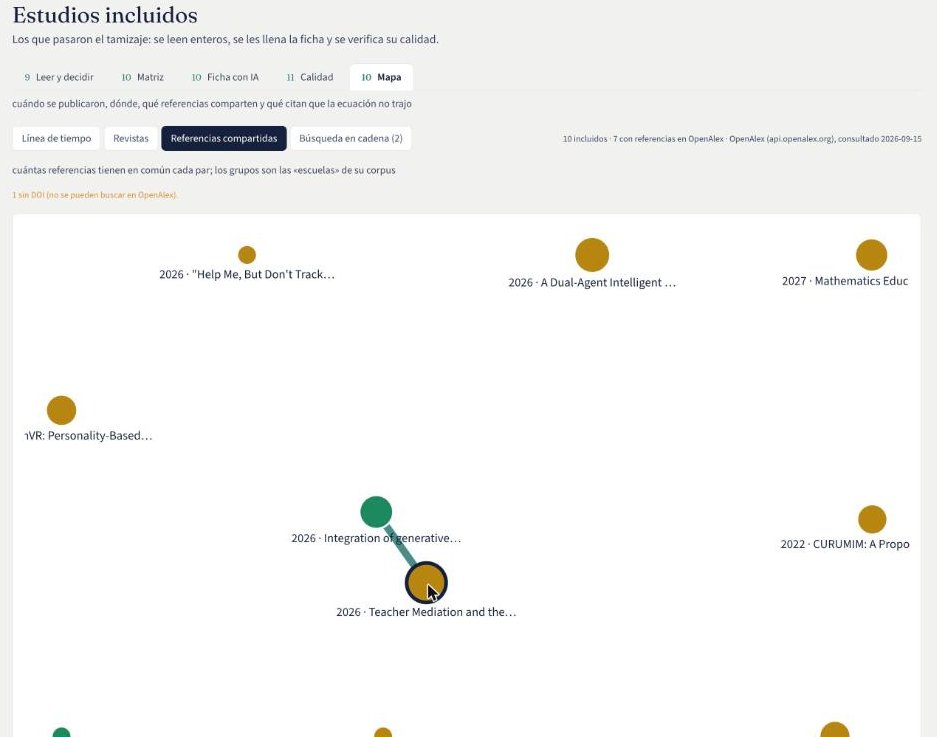
Con diez estudios de 2026 el grafo es ralo —un solo par comparte lecturas—, pero ya produjo lo más útil: la lista de lo que dos o más incluidos citan y la ecuación no trajo. Hoy son dos: un texto de método (análisis temático) y Kasneci et al. (2023), «ChatGPT for good?», el artículo que medio campo cita para hablar de riesgos y oportunidades. Ese sí es candidato. Se marca, se importa como búsqueda en cadena, entra al diagrama por la columna «otros métodos» con su procedencia escrita («citado por #3794 y #4009») y se tamiza como cualquier registro. La búsqueda en cadena es un paso que PRISMA exige y que casi siempre se hace a mano y sin rastro; aquí queda hecho y declarado.
Y el fallo doce, para cerrar la serie: el primer despliegue del mapa salió vacío porque OpenAlex ahora cobra por dirección IP y el servidor compartido había gastado su cupo gratis del día. Se ve en la pantalla —«OpenAlex respondió 429»— en vez de fallar en silencio, y el respaldo en Crossref, que no tiene cuota, trae incluso más referencias.
Lo que la revisión le enseñó a la herramienta
En dos días la revisión real encontró doce fallos que una revisión de prueba y una simulación no habían encontrado: la fusión que perdía el DOI, el botón que se movía, los descriptores de dos palabras, el orden que pisaba el puntaje de las sugerencias, el orden sin porqué, el orden que aprendió «revisión» y luego «copyright» y luego «multimodal», el PDF ajeno, el diagrama que no declaraba los pendientes, las entidades HTML en las referencias, la cuota de OpenAlex. Todos están corregidos y todos tienen prueba. Lo cuento porque es exactamente lo que le pedimos a la máquina: someterse a auditoría y corregirse con datos. Y porque el método —dejar escrito por qué cada número es ese— es lo que hizo visibles los fallos.
Lo que no hace, dicho de frente
- No reemplaza al segundo revisor humano. El método prefiere dos personas tamizando a ciegas. La segunda opinión de la IA es un sustituto parcial, y así se declara en el informe; nunca «segundo revisor».
- No tiene validación publicada. Lleva una revisión de prueba, la doctoral en curso —la de arriba— y la comparación en tres corpus públicos que conté, donde ASReview gana. ASReview tiene un artículo en Nature Machine Intelligence; yo tengo un póster. Ese póster se presenta el 15 y 16 de octubre en la Facultad de Ciencias de la UIS, en el encuentro IA & Ciencia: investigar con máquinas, y ahí espero exactamente lo que este artículo pide: que la rompan.
- No promete recall. Garantiza que nada se descarta sin lectura y que lo no leído se ve.
Cuándo se libera, y cómo probarla antes
La aplicación está en línea en prisma-wizard-web.vercel.app. Hoy las cuentas se crean a mano, porque el servidor es gratuito y quiero saber quién entra mientras la afinamos. Si usted está haciendo una revisión —de educación, de salud, de ingeniería, da igual— y quiere probarla con su corpus, escríbame y le abro una cuenta. A cambio le pido una cosa: que me diga dónde se rompe.
El código se libera después del encuentro de la UIS, con licencia libre, junto con el simulador para que cualquier grupo mida su propio orden de lectura. Hasta entonces, este artículo es la promesa y el póster es la evidencia: descargue el póster.
Y si nunca ha hecho una revisión sistemática y todo esto le sonó a otro idioma, escribí una guía que la cuenta entera como el concurso para un cargo, término por término, con un símil por cada uno. Se la comparto en el próximo artículo.
Comentarios (0)
- Sé el primero en comentar.